Algorithm Guide
快速熟悉常用的数据结构以及它们的应用场景,了解常用算法的模板。
数据结构
线性结构
数组 Array
- 内存连续,适合较少的相同类型的数据
- 支持随机访问,通过索引快速访问数据,时间复杂度为
O(1) - 遍历查找元素的时间复杂度为
O(n) - 插入删除元素的时间复杂度为
O(n)
适合的场景:
- 读操作多
- 基于索引进行操作
循环数组
TODO
位图 BitMap
TODO
链表 List
- 内存分散,通过指针指向下一个节点,可用于较多的相同类型的数据
- 遍历查找元素的时间复杂度为
O(n) - 支持快速插入删除,时间复杂度为
O(1)
适合写操作多的场景。
堆栈/栈 Stack && 队列 Queue
- Stack, FILO
- 栈顶操作的时间复杂度为
O(1)
- 栈顶操作的时间复杂度为
- Queue, FIFO
- 头尾操作的时间复杂度为
O(1)
- 头尾操作的时间复杂度为
应用场景:
- 校验表达式的有效性
线性结构的双指针遍历
前后指针
public ListNode reverseList(ListNode head) {
  ListNode pre = null;
  ListNode cur = head;
  while (cur != null) {
    ListNode tmp = cur.next;
    cur.next = pre;

    pre = cur;
    cur = tmp;
  }
  return pre;
}
快慢指针
public boolean hasCycle(ListNode head) {
  ListNode fast = head;
  ListNode slow = head;
  while (fast != null && fast.next != null) {
    slow = slow.next;
    fast = fast.next.next;

    if (slow == fast) {
      return true;
    }
  }
  return false;
}
头尾指针向中间靠拢
适合在有序数组中查找某个值或者边界。
int l = i + 1;
int r = nums.length - 1;
while (l <= r) {
  int total = cur + nums[l] + nums[r];
  if (total == 0) {
    // process logic
    ...
    ++l;
    --r;
  } else if (total > 0){
    --r;
  } else {
    ++l;
  }
}
优先队列 PriorityQueue
对输入的元素进行排序,按照优先级来输出。
常见的应用场景:
- 任务的优先级排序
- 返回第 K 大的元素
- 滑动窗口
哈希 Hash
- 哈希函数
- 哈希碰撞
- 查找的时间复杂度为
O(1)
常见的应用场景:
- 唯一性快速查找对象,先进行
hash哈希比较,然后equal等值比较
树 && 图
每个节点都包含以下信息:
- 当前节点的值
- 所有连接子节点的边
二叉树
- 满二叉树,除了叶子节点之外,每个节点都有左右两个子节点
- 完全二叉树,叶子节点都在最底下两层,最后一层的叶子节点都靠左排列,并且除了最后一层,其他层的节点个数都要达到最大
存储方式:
- 基于指针或者引用的二叉链式存储法
- 基于数组的顺序存储法,适用于完全二叉树。如果节点 X 存储在数组中下标为 i 的位置
- 左子节点,的下标为
2 * i的位置 - 右子节点的下标为
2 * i + 1的位置 - 父节点的下标为
i/2的位置
- 左子节点,的下标为
二叉搜索树 BST(Binary Search Tree)
特点:
- 左子树上所有节点的值都小于根节点的值
- 右子树上所有节点的值都大于根节点的值
- 左右子树也都满足 BST 的特点
对 BST 进行中序遍历,可以构成一个有序数组。
不管操作是插入、删除还是查找,时间复杂度其实都跟树的高度成正比,也就是 O(height)。 平衡二叉搜索树的高度接近 logn,所以平均查询时间复杂度 O(logN), 但 BST 不是一个自平衡的树,最坏情况下会退化成链表,导致时间复杂度为 O(N)。
平衡二叉树 AVL
平衡二叉树是一棵空树或它的左右两个子树的高度差的绝对值不超过1,并且左右两个子树都是一棵平衡二叉树。
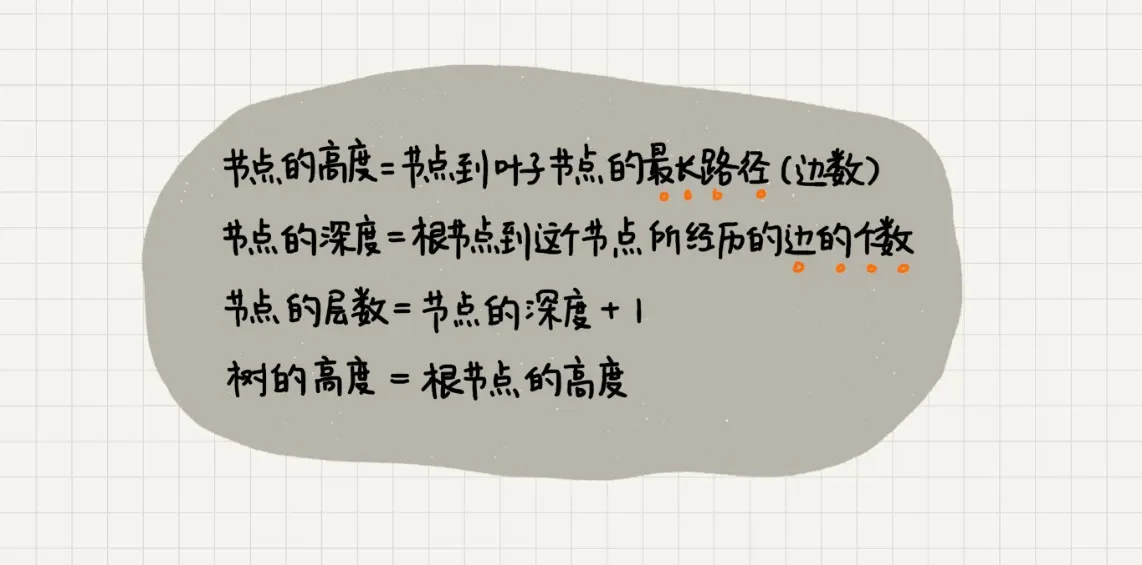
高度=从当前节点到子树中最远叶子节点的最长路径上的边数,即该路径上的节点数 - 1,可通过层级遍历计算。 树的高度就等于根节点的高度。
当不平衡时,需要通过旋转来调平二叉树。
2-3 树 && 红黑树
红黑树是使用二叉树对 2-3 树的一种实现,它并不追求严格的平衡,而是大致的平衡。 它的高度近似 2 log₂ n
- 根节点必为黑色
- 节点颜色有红色和黑色,红色节点和其黑色父节点结合起来,相当于 2-3 树中的一个节点
- 所有叶子节点都是黑色
- 任意节点到叶子节点经过的黑色节点数目相同,只有黑色节点才贡献高度值
- 不会有连续的红色节点,红色节点必要要和黑色父节点结合才有意义
节点中的每条边决定了要查找的数据的范围。
红黑树在最坏的情况下查找、插入、删除的时间复杂度始终是 O(logN)。
Rerefence:
B+ 树/多叉搜索树
叶子节点通过双向链表进行连接,如果我们要求某个区间的数据。只需要拿区间的起始值,在树中进行查找, 当查找到某个叶子节点之后,再顺着链表往后遍历,直到链表中的结点数据值大于区间的终止值为止。
如何解决这个索引占用太多内存的问题呢?借助时间换空间的思路,把索引存储在硬盘中,而非内存中。 通常内存的访问速度是纳秒级别的,而磁盘访问的速度是毫秒级别的。 读取同样大小的数据,从磁盘中读取花费的时间,是从内存中读取所花费时间的上万倍,甚至几十万倍。
比起内存读写操作,磁盘 IO 操作非常耗时,为了尽量减少磁盘 IO 操作,通过增加每个节点的子节点的数量,来尽量降低树的高度。
通过实现 m 叉树来实现 B+ 树。不管是内存中的数据,还是磁盘中的数据,操作系统都是按页(一页大小通常是 4KB,这个值可以通过 getconfig PAGE_SIZE 命令查看)来读取的,一次会读一页的数据。如果要读取的数据量超过一页的大小,就会触发多次 IO 操作。 所以,我们在选择 m 大小的时候,要尽量让每个节点的大小等于一个页的大小。读取一个节点,只需要一次磁盘 IO 操作。
新增/删除等操作会引发以下的操作:
- 合并
- 分裂
堆
堆的特点:
- 一个完全二叉树,最常用的存储方式就是数组。
- 每一个节点的值都必须**大于等于(大顶堆)/小于等于(小顶堆)**其子树中每个节点的值。
应用场景:
- 优先级队列的实现
- 高性能定时器,基于时间进行排序,只需要一次比较堆顶顶时间即可
- 求中位数,通过维护一个大顶堆和一个小顶堆,大顶堆存储小于等于中位数的数据,小顶堆则存储大于中位数的数据,最后大顶堆的堆顶元素即为中位数。
字典树 Trie
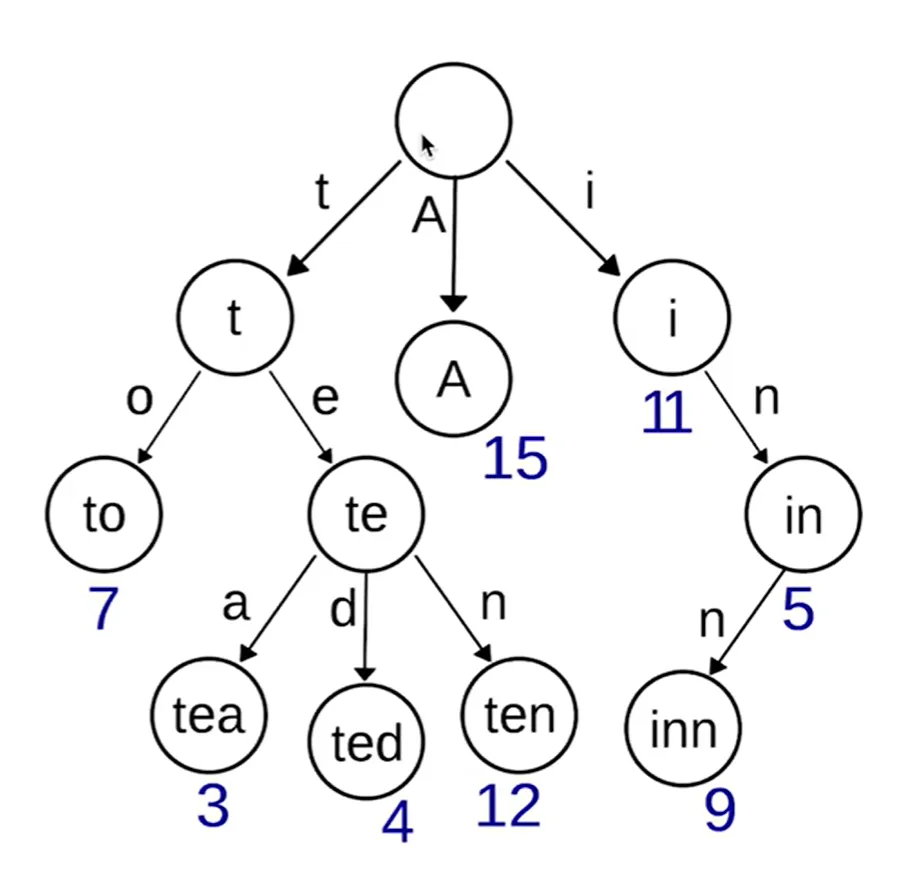
树形结构,通过每个节点的边来维护公共前缀字符串,即键值。
利用公共前缀来降低查询时间的开销以提高查询效率。
class Trie {
  private final Trie[] children;
  private boolean isEnd;

  public Trie() {
    children = new Trie[26];
    isEnd = false;
  }

  public void insert(String word) {
    Trie node = this;
    for (int i = 0; i < word.length(); i++) {
      char ch = word.charAt(i);
      int index = ch - 'a';
      if (node.children[index] == null) {
        node.children[index] = new Trie();
      }
      node = node.children[index];
    }
    node.isEnd = true;
  }

  public boolean search(String word) {
    Trie node = searchPrefix(word);
    return node != null && node.isEnd;
  }

  public boolean startsWith(String prefix) {
    return searchPrefix(prefix) != null;
  }

  private Trie searchPrefix(String prefix) {
    Trie node = this;
    for (int i = 0; i < prefix.length(); i++) {
      char ch = prefix.charAt(i);
      int index = ch - 'a';
      if (node.children[index] == null) {
        return null;
      }
      node = node.children[index];
    }
    return node;
  }
}
应用场景:
- 基于前缀的搜索/推荐
- 搜索引擎的文本词频统计以及搜索
倒排索引
TODO
遍历方式
- 前序遍历,根左右
- 中序遍历,左根右
- 后序遍历,左右根
- 层级遍历
广度遍历 BFS
// 收集当前层的节点
Deque<TreeNode> queue = new ArrayDeque<>();
queue.addLast(root);
var result = new ArrayList<List<Integer>>();
while (!queue.isEmpty()) {
  // 队列中当前层的节点数量
  int count = queue.size();
  List<Integer> layer = new ArrayList<>(count);
  while (count-- != 0) {
    // 获取当前层的节点
    TreeNode node = queue.removeFirst();
    layer.add(node.val);

    // 插入当前节点的下一层所有节点
    if (Objects.nonNull(node.left)) {
      queue.addLast(node.left);
    }
    if (Objects.nonNull(node.right)) {
      queue.addLast(node.right);
    }
  }
  result.add(layer);
}
深度遍历 DFS
计算机一般使用 DFS 来解决问题,例如堆栈的使用。
- 终止条件
- 当前节点的计算
- 对子节点的遍历,可以使用剪枝来优化遍历
- 节点状态,可选
- 子节点遍历前的状态设置
- 子节点遍历后的状态清理
private int dfs(TreeNode node, Long preSum, Map<Long, Integer> preSums, int targetSum) {
  if (node == null) {
    return 0;
  }

  preSum = preSum + node.val;
  int count = preSums.getOrDefault(preSum, 0) + 1;
  // 设置当前结点的状态
  preSums.put(preSum, count);

  // 收集当前结点的结果
  int ret = preSums.getOrDefault(preSum - targetSum, 0);

  // 对子节点进行遍历
  ret += dfs(node.left, preSum, preSums, targetSum);
  ret += dfs(node.right, preSum, preSums, targetSum);

  // 基于子节点的结果来计算当前结果

  // 清理当前结点的状态
  preSums.put(preSum,  count - 1);
  return ret;
}
并查集 union & find
- 初始化,每个元素的 root 指向自己或者用flag标记为root
- Union,合并关联数据
- Find
public class UnionFind {
  private final int[] roots;
  public UnionFind(int n) {
    roots = new int[n];
    for(int i = 0; i < n; i++) {
      roots[i] = i;
    }
  }

  private int find(int i) {
    int root = i;
    // 找到根,如果 root == roots[root],则 root 为根
    while (root != roots[root]) {
      root = roots[root];
    }

    // 优化:路径压缩, 将同一组的元素的根都设为最顶层的根
    while (i != roots[i]) {
      int next = roots[i];
      roots[i] = root;
      i = next;
    }
    return root;
  }

  public void union(int p, int q) {
    int pr = find(p);
    int qr = find(q);
    roots[pr] = qr;
  }

  public boolean isConnected(int p, int q) {
    return find(p) == find(q);
  }
}- Union 优化:将深度较小的元素的 root 作为另一个元素的 root 的 root。
- Find 优化:对路径进行压缩,使路径的深度不会过大
应用场景:
- 对数据进行合并归类
跳表
跳表可以理解为在链表基础上,建立多级索引,通过多级索引检索定位将增删改查的时间复杂度变为 O(logN) 。
查询的主要过程是定位到小于要查的 value 的最大值的节点, 从跳表最高级的索引开始定位,找到该索引中小于要查的 value 的最大值的节点, 然后继续定位到该节点的下一级索引,继续之前的查找操作。
Reference:
布隆过滤器 Bloom Filter
通过映射函数(类似哈希函数)映射到二进制向量中,用于检索一个元素是否在一个集合中。 如果它判断出不在,则该元素一定不在集合中; 如果判断出存在,则该元素不一定在集合中,因为可能存在映射冲突,多个元素的映射值相同,但元素不相同。
主要用于识别元素不存在集合中。
遍历技巧
剪枝
在遍历过程中,对不必要的节点进行过滤,提高遍历的效率。
递归 && 分治
把一个大的问题分解为相同的小问题,对每个小问题进行求解,最后合并得到最终的结果。
- 递归终止条件
- 子问题
动态规划
必要元素:
- 状态定义,定义要保存哪些结果数据用于后续推导
- 状态初始化
- 状态转移方程/递推公式,基于之前的结果来推导现有的结果。可以先用 递归 + 状态 来思考,然后转换为 递推(循环)
public int climbStairs(int n) {
  // 状态定义,保存每一步的方法数量
  int[] result = new int[n + 1];
  // 初始化
  result[0] = 0;
  result[1] = 1;
  for (int i = 2; i <= n; i++) {
    // 递推公式
    result[i] = result[i - 2] + result[i - 1];
  }
  return result[n];
}
常见的优化技巧
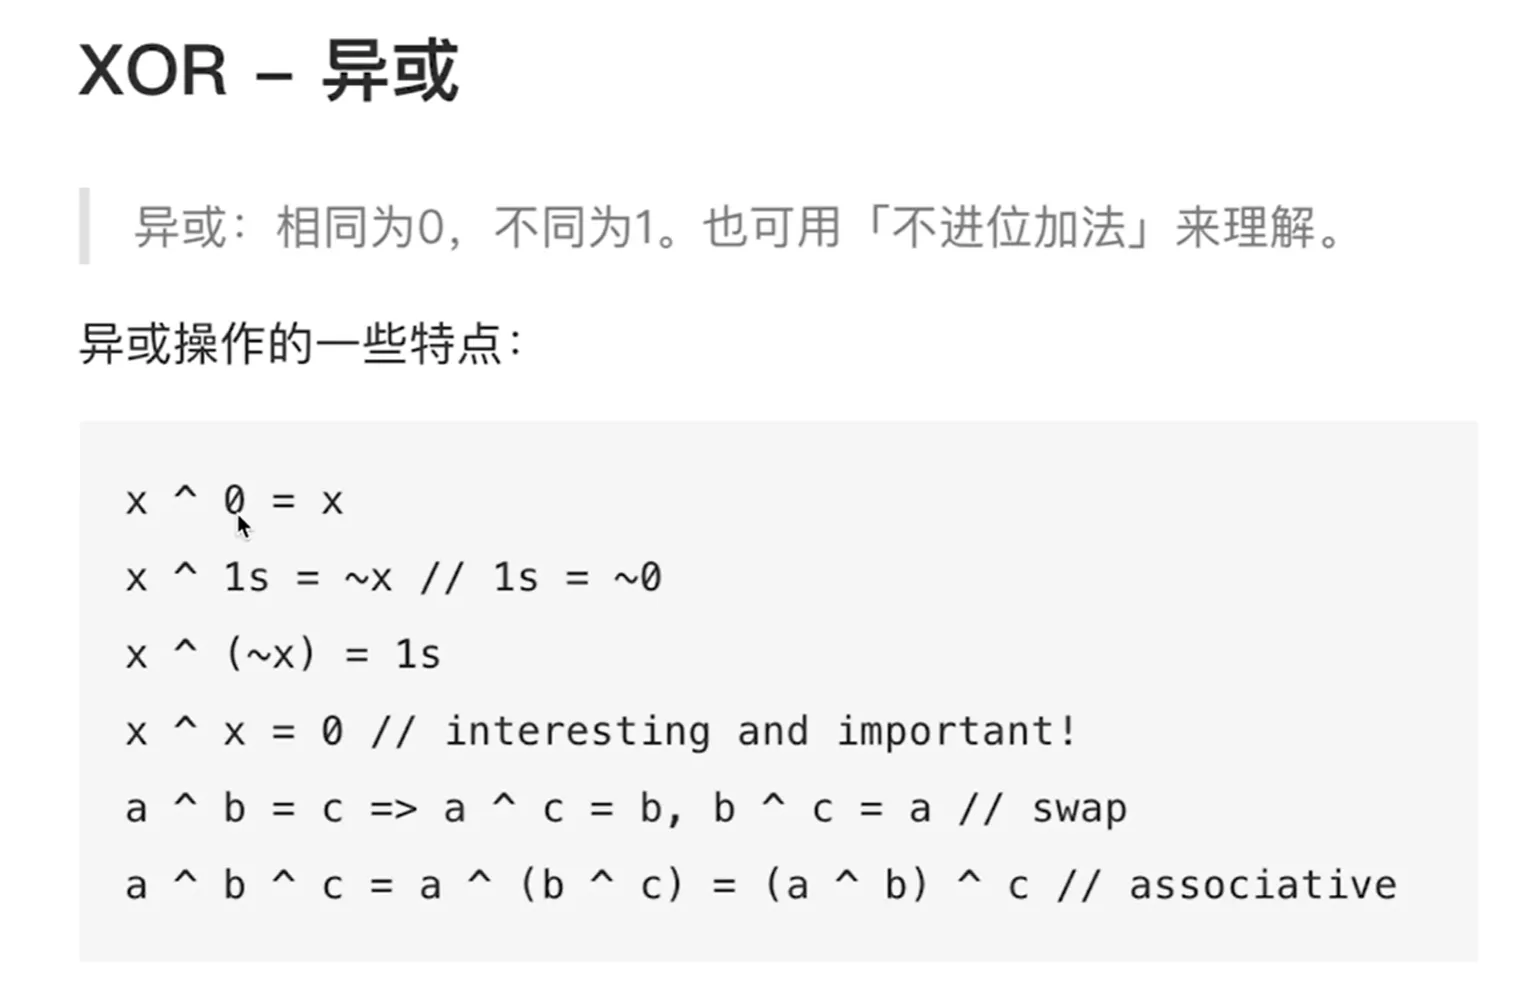
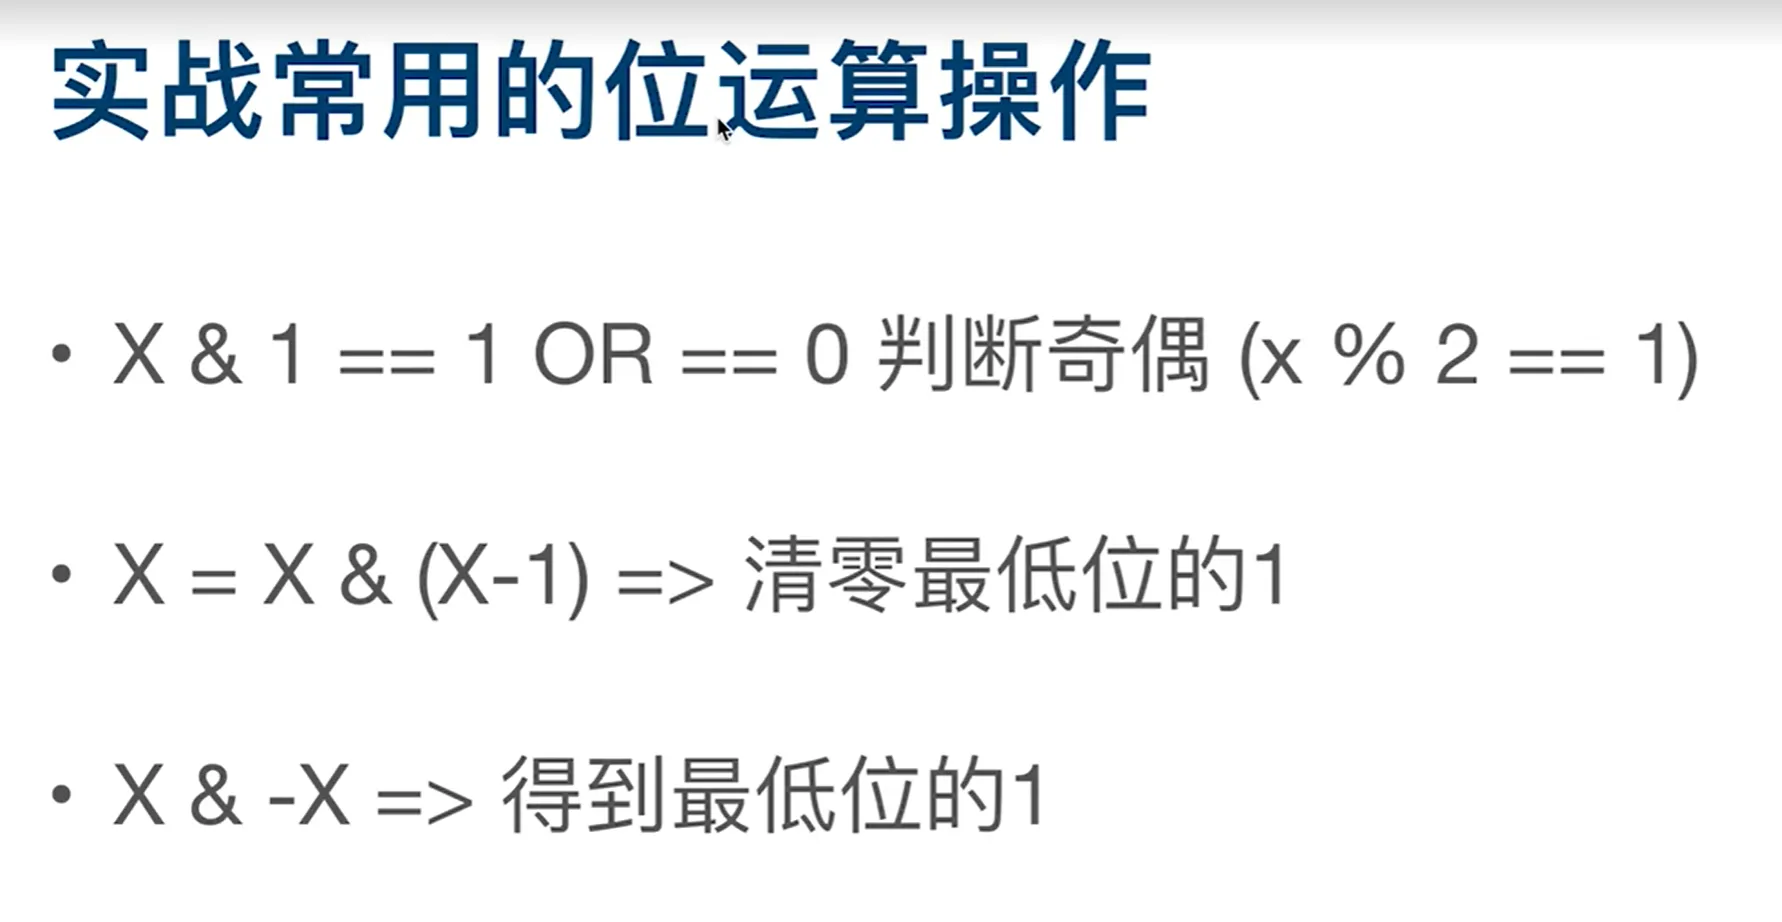
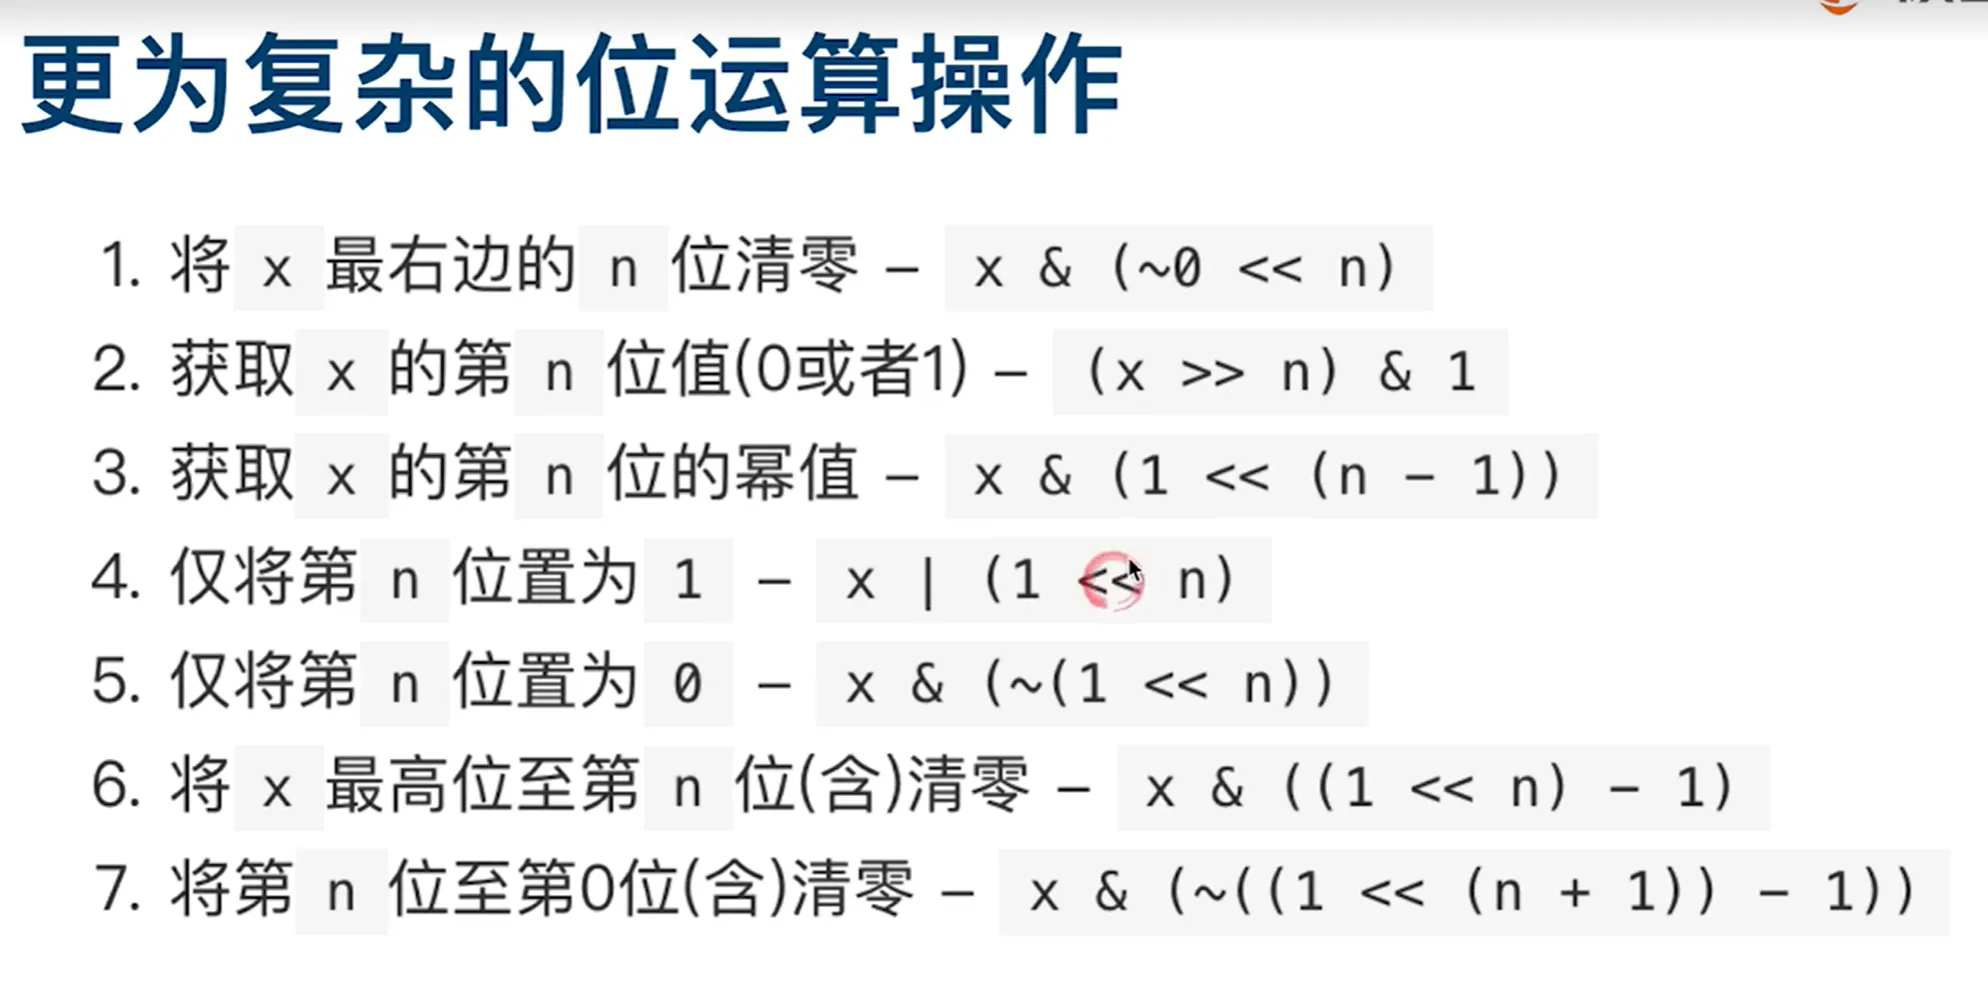
位运算
排序
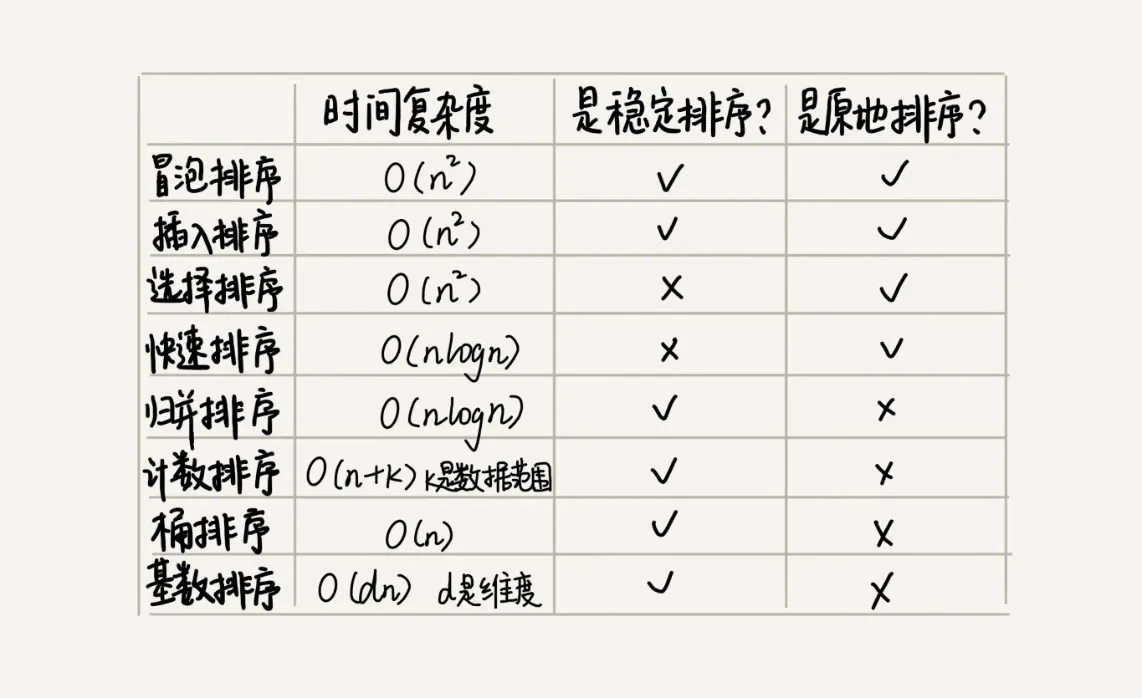
排序相关的评估指标:
- 时间复杂度
- 空间复杂度
- 原地排序,特指空间复杂度是
O(1)的排序算法。
- 原地排序,特指空间复杂度是
- 稳定性,如果待排序的序列中存在值相等的元素,经过排序之后,相等元素之间原有的先后顺序不变。
- 是否基于比较和交换进行排序
稳定排序算法常用语多字段排序,它可以保证值相等的元素基于上一次排序的结果进行排序,值不想等的按照当前的稳定排序算法进行排序。
快速排序
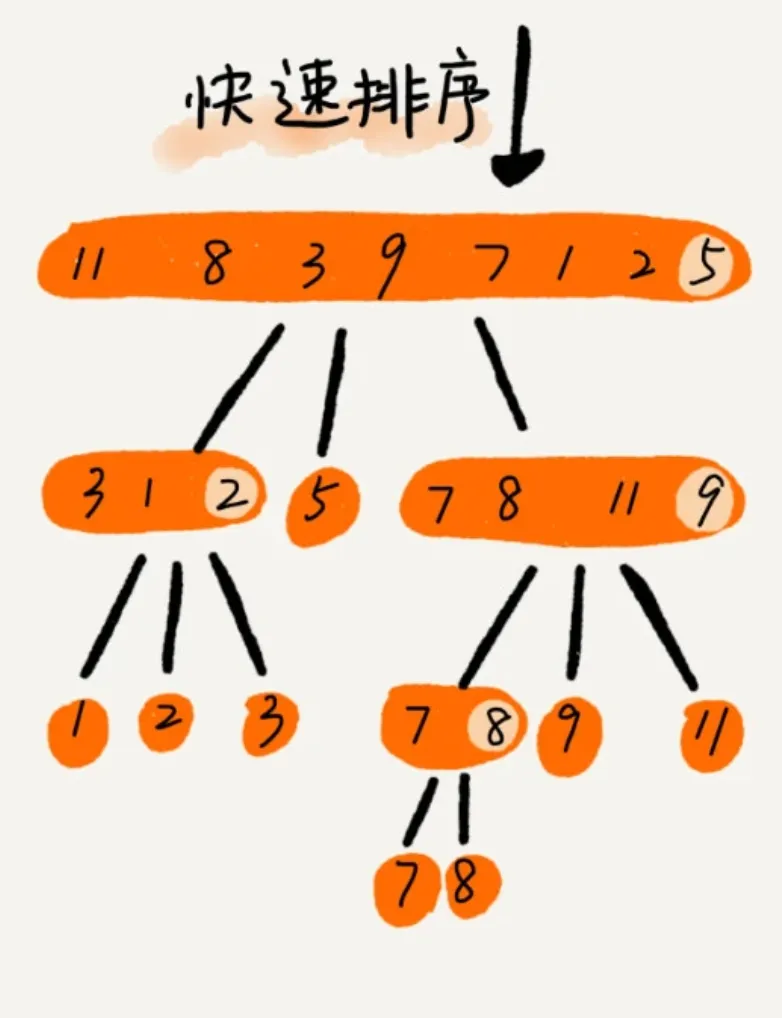
快排是一种原地、不稳定的排序算法,也是使用的就是分治思想。 为每次迭代的区间确定一个 pivot 分区点,基于 pivot 进行分区处理。
归并排序
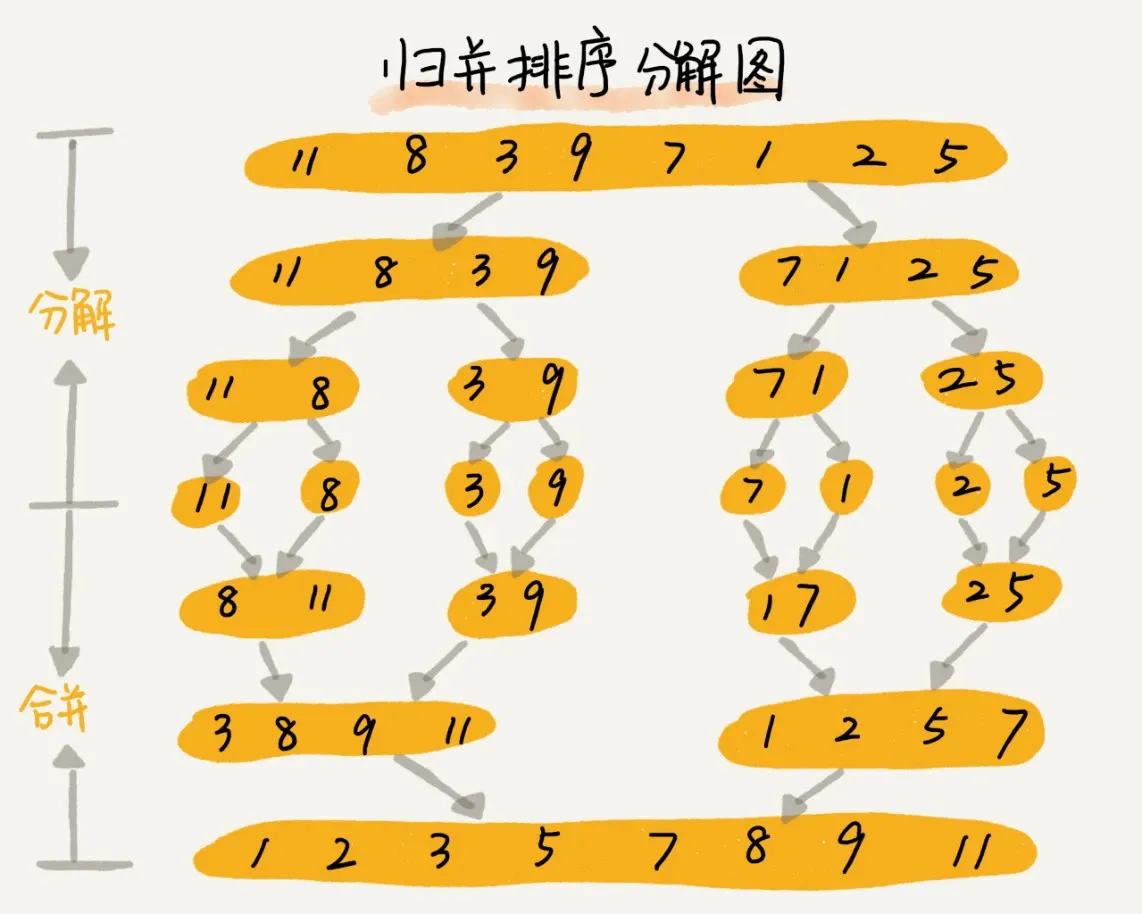
归并排序使用的就是分治思想。将一个大问题分解成小的子问题来解决。
它的时间复杂度为 O(nlogn),空间复杂度为 O(n),不是原地排序。
桶排序
时间复杂度是线性的 O(n)。适合外部排序,即数据存储在外部磁盘中,数据量比较大,内存有限,无法将数据全部加载到内存中。
它会对数据进行分片,分到有序的桶中,再对每个桶中的数据进行排序。
计数排序是一种特殊的桶排序,基于某个维度的数据范围进行分桶,适用于数据范围不大的场景。
搜索
二分查找
前提条件:
- 元素有序性, 单调递增或者递减
- 有界,存在上下界
- 可通过索引访问,一般用于数组
// x 平方根的整数部分 ans 是满足 k^2 ≤ x 的最大 k 值
public int mySqrt(int x) {
  int left = 0;
  int right = x;
  int ans = -1;
  while (left <= right) {
    int mid = left + (right - left) / 2;
    if ((long) mid * mid <= x) {
      ans = mid;
      left = mid + 1;
    } else {
      right = mid - 1;
    }
  }
  return ans;
}

private boolean search(int[] row, int target) {
  int l = 0;
  int r = row.length - 1;
  while (l <= r) {
    int m = l + (r - l) / 2;
    if (row[m] == target) {
      return true;
    }

    if (row[m] < target) {
      l = m + 1;
    } else {
      r = m - 1;
    }
  }
  return false;
}
查找链表的中间节点
ListNode pre = head;
ListNode slow = head;
ListNode fast = head;
// 快指针的终止条件
while (fast != null && fast.next != null) {
  pre = slow;
  slow = slow.next;
  fast = fast.next.next;
}
字符串匹配算法
BF 算法 && RK 算法
BF(Brute Force) 算法,即暴力匹配算法,也叫朴素匹配算法。
在长度为 n 的主串中,检查起始位置分别是 0、1、2…n-m 且长度为 m 的 n-m+1 个子串,
看有没有跟长度为 m 的模式串匹配的。它的时间复杂度为 O(n*m)。
RK(Rabin-Karp)算法是 BF 算法的优化,引入特殊设计的哈希算法,通过比较子串和模式串的哈希值,而不是字符串比较。它的时间复杂度为 O(n)。
BM 算法
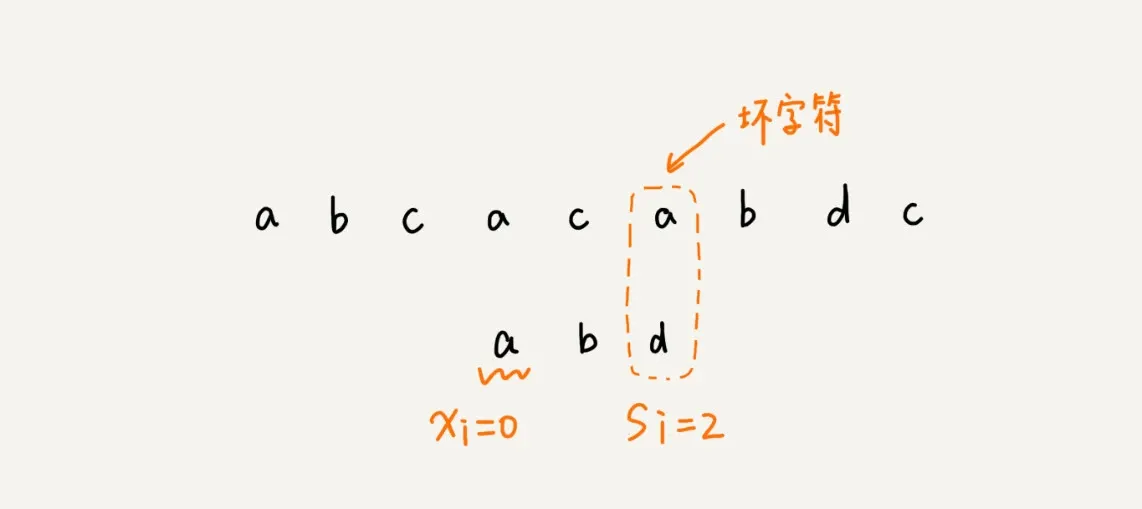
BM(Boyer-Moore)算法,在模式串与主串匹配的过程中,当模式串和子串某个字符不匹配的时候,这个字符被称为坏字符,它在模式串中的索引为 si,通过滑动模式串来寻找模式串中坏字符的位置 xi,然后计算出下次匹配用的子串的位置需要移动的位数 si - xi,跳过一些肯定不会匹配的情况。
KMP 算法
KMP(Knuth Morris Pratt)算法,试图寻找一种规律:在模式串和主串匹配的过程中,当遇到坏字符后,只需要在子串的好前缀的后缀子串中,查找最长的那个可以跟模式串的好前缀的前缀子串匹配的。假设最长的可匹配的那部分前缀子串是 {v},长度是 k,模式串中坏字符的索引为 j,主串中坏字符的索引为 i。那么就可以把子串的位置一次性往后滑动 j-k 位。子串和模式串的匹配过程中,每次遇到坏字符的时候,就把 j 更新为 k,i 不变,然后继续比较。
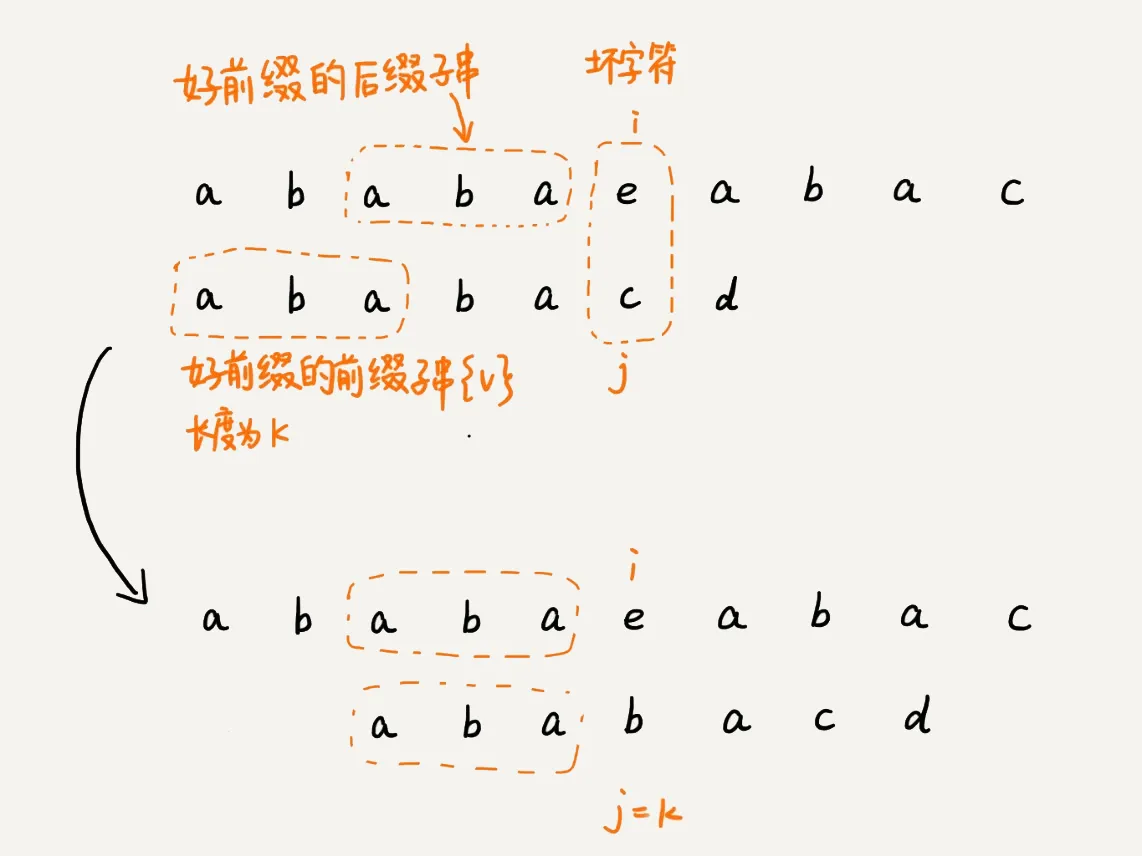
它的空间复杂度为 O(m),m 表示模式串的长度;时间复杂度就是 O(m+n)。
其他应用场景
前缀和
主要用于求解任意区间的子序列和。
private static int[] getRange(int avg, int[] nums) {
  // 初始化,计算每个前缀区间 [0, i) 的和
  int[] preSum = new int[nums.length + 1];
  for(int i = 1; i <= nums.length; i++) {
    preSum[i] = preSum[i - 1] + nums[i - 1];
  }

  int[] result = new int[0];
  int maxLen = 0;

  for(int i = 0; i < nums.length; i++) {
    int end = i;
    for (int j = i + 1; j <= nums.length; j++) {
      // 计算区间和,[i, j)
      int sum = preSum[j] - preSum[i];
      // 计算区间中的元素数量
      int len = j - i;

      int lost = len * avg;
      if (sum > lost) {
        break;
      }

      end = j;
    }

    int curLen = end - i;
    if (curLen == 0) {
      continue;
    }

    if (curLen <= maxLen) {
      continue;
    }

    result = new int[] {i, end};
    maxLen = curLen;
  }

  return result;
}
滑动窗口
- (常用)使用 queue 来构建有序队列。
- 针对数组,还可以使用双指针来确定窗口的范围。
// 构建从大到小的有序队列
Deque<Integer> queue = new ArrayDeque<>(k);
...
int[] rst = new int[nums.length - k + 1];
for (int i = k - 1; i < nums.length; i++) {
  // 构建从大到小的有序队列
  while (!queue.isEmpty() && nums[queue.getLast()] <= nums[i]) {
    queue.removeLast();
  }
  // 添加当前元素
  queue.addLast(i);

  // 计算滑动窗口的起始位置
  int start = i - k + 1;
  // 清理不属于滑动窗口范围的旧数据
  while (queue.getFirst() < start) {
    queue.removeFirst();
  }
  // 获取有序队列中的最大值
  rst[start] = nums[queue.getFirst()];
}
LRU Cache
LRU(Least Recently Usage) 指最近最少使用的缓存策略。
可以使用双向链表来实现,将最近使用的放在头部,而最近最少使用的会放在尾部, 当缓存满的时候,会将尾部最近最少使用的元素移除。
- 头部查询时间复杂度 O(1)
- 尾部删除时间复杂度 O(1)
实现思路版本,任何语言都可以参考。
class LRUCache {
  private final LinkedList<Integer> keys;
  private final HashMap<Integer, Integer> cache;
  private final int capacity;

  public LRUCache(int capacity) {
    this.capacity = capacity;
    keys = new LinkedList<>();
    cache = new HashMap<>(capacity);
  }

  public int get(int key) {
    // 检查缓存是否命中
    if (!cache.containsKey(key)) {
      return -1;
    }

    // 命中后,移到最新的位置
    mvToNewest(key);
    return cache.get(key);
  }

  public void put(int key, int value) {
    if (cache.containsKey(key)) {
      // 缓存命中,移到最新的位置,更新值
      mvToNewest(key);
      cache.put(key, value);
      return;
    }

    // 未命中,则添加到最新的位置
    keys.addFirst(key);
    cache.put(key, value);
    if (keys.size() > capacity) {
      // 如果超出缓存大小,移除最老的
      Integer oldestKey = keys.removeLast();
      cache.remove(oldestKey);
    }
  }

  private void mvToNewest(int key) {
    keys.remove(Integer.valueOf(key));
    keys.addFirst(key);
  }
}
Java 可以借助 LinkedHashMap 来实现
class LRUCache extends LinkedHashMap<Integer, Integer> {
  private int capacity;

  public LRUCache(int capacity) {
    super(capacity, 0.75F, true);
    this.capacity = capacity;
  }

  public int get(int key) {
    return super.getOrDefault(key, -1);
  }

  public void put(int key, int value) {
    super.put(key, value);
  }

  @Override
  protected boolean removeEldestEntry(Entry<Integer, Integer> eldest) {
    return size() > capacity;
  }
}
双指针确定边界
public int removeDuplicates(int[] nums) {
  if (nums.length <= 2) {
    return nums.length;
  }

  int l = 2;
  for(int r = 2; r < nums.length; r++) {
    // l 是要写的位置
    // nums[r] == nums[l - 2] => [l-2, r] 都一样,
    // 而 r >= l,即有超过2个连续一样的
    if (nums[r] != nums[l - 2]) {
      nums[l] = nums[r];
      ++l;
    }
  }

  return l;
}